参数翻倍价格降到三分之一,DeepSeek新模型顶替自家旗舰

9月14日中午12点之后,所有发往 deepseek-v4-pro 的请求会由另一个模型接走,账单也按另一个模型的价格算。这是 DeepSeek 在 9 月 10 日发布 V4.1-Flash 时一起宣布的安排,新模型顶替旗舰,一直顶到 V4.1 Pro 上线,而 V4.1 Pro 没有公布日期。同一天,权重以 MIT 许可传上 Hugging Face,技术报告一起放出。
先把账算清楚。V4 Pro 的离峰价是每百万 token 缓存命中输入 0.022 美元、未命中输入 0.66 美元、输出 1.98 美元。V4.1 Flash 是 0.003、0.15、0.6 美元,峰值时段翻倍,峰值定在工作日 UTC 01 点至 04 点和 06 点至 10 点。把原来走 Pro 的流量搬过去,输出这一项大约只剩三分之一,未命中输入大约只剩四分之一。DeepSeek 给出的理由是 V4.1 Flash 在性能、成本、速度和总耗时上都超过了 V4 Pro。
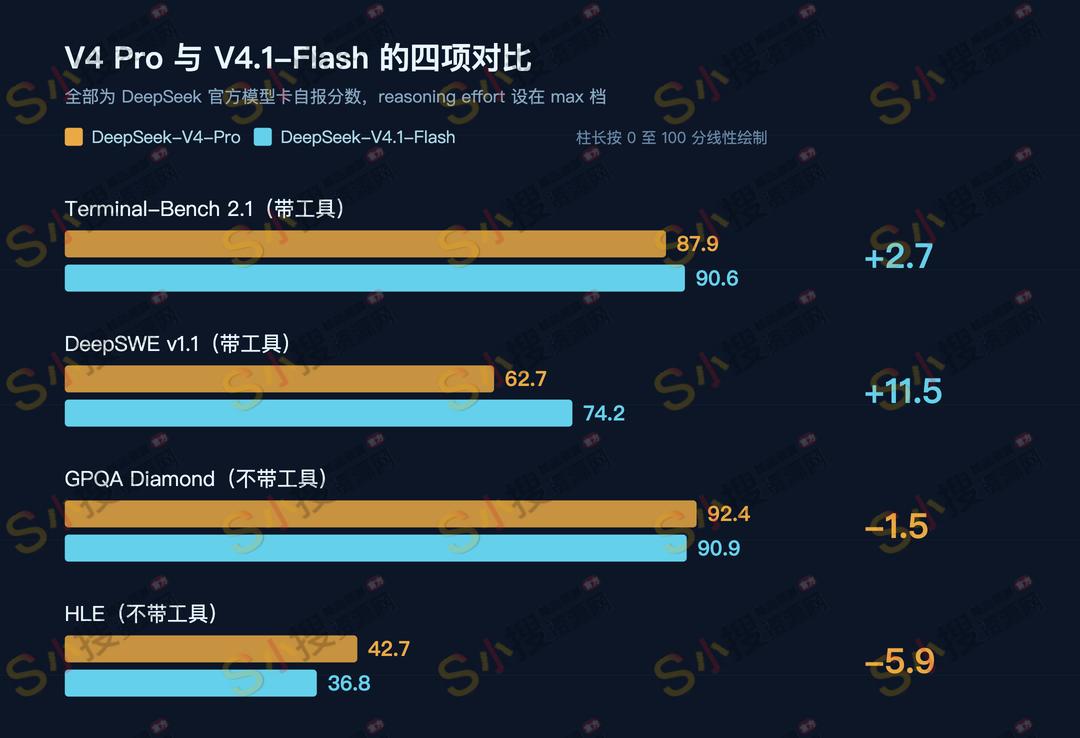
这个理由在带工具的任务上站得住,在不带工具的知识题上站不住。官方模型卡里,V4.1 Flash 的 Terminal-Bench 2.1 拿到 90.6,V4 Pro 是 87.9,GPT-5.6 是 88.8。DeepSWE v1.1 拿到 74.2,高于 Opus 5 的 74.0 和 GPT-5.6 Sol 的 73.0,上一代 V4-Flash 只有 54.4。换一张表看又是另一回事,GPQA Diamond 90.9 对 V4 Pro 的 92.4,HLE 无工具 36.8 对 42.7,两项都退了,而这两项不需要调工具,考的是记住了多少和想得有多深。
我倾向于把这次切换理解成给新架构清场,而不是小模型真把大模型压下去了。V4 Pro 主干 1.6T,V4.1 Flash 主干 552B,参数只有前者的三分之一左右,可用户直接感知的推理价格和延迟都下来了,对一家卖 API 的公司来说,这比榜单名次更要紧。DeepSeek 要让 V4.1 这一代架构把量跑起来,最省事的做法就是让贵的那一档停掉,哪怕它在知识类题目上还更强。
架构里改动最大的一块是缓存。
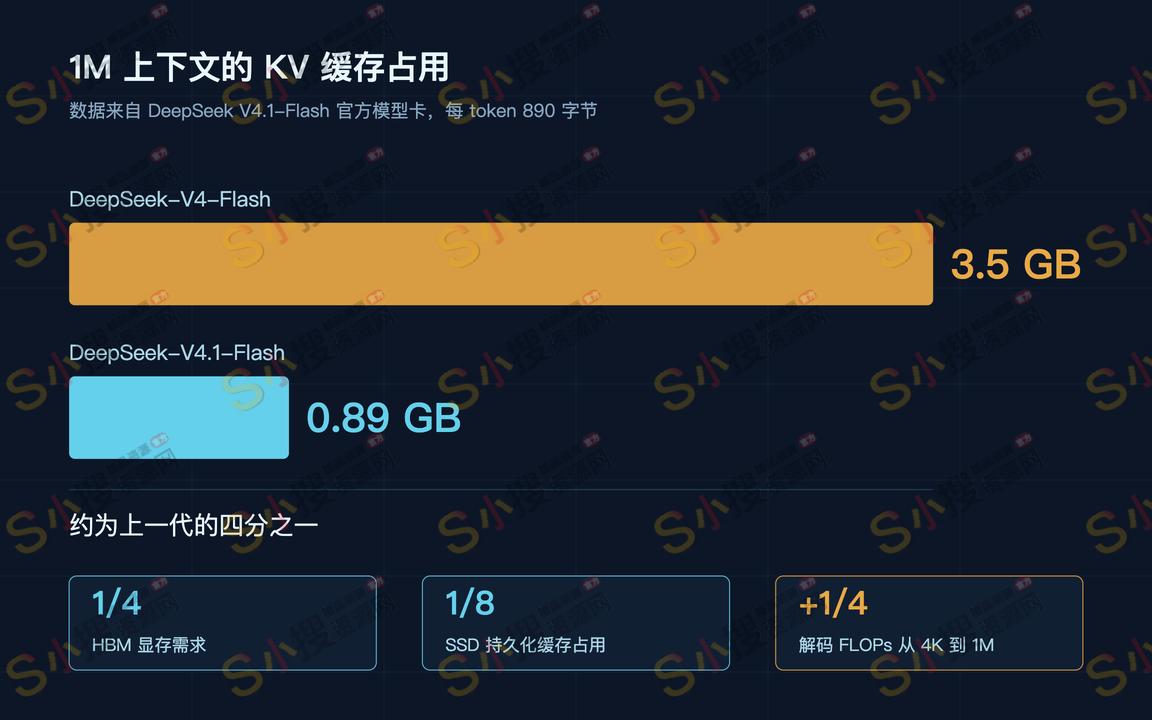
V4.1 Flash 用的是 DeepSeek 称之为 Causal Encoder-Decoder 的结构,一个 40 层的 Transformer 被拆成 20 层因果编码器和 20 层解码器。解码器的全局 KV 缓存不再由自己逐层生成,而是从编码器的最后一层隐状态投影出来。配套的是 Compressed Sparse Attention 2,主 KV 用 FP4 存,加上 SWA Bounded Replay 处理滑窗那部分。结果写在模型卡上,全局 KV 每 token 约 890 字节,大约是本代 V4-Flash 的四分之一,官方口径是 HBM 需求降到四分之一、SSD 占用降到八分之一,相对 2023 年的 DeepSeek-V1 是 437 倍。
这个数字乘一下就有感觉。890 字节乘以 100 万 token,一条填满 1M 上下文的序列大约占 890 MB 缓存,上一代按同样算法要超过 3.5 GB。模型卡还说,解码 FLOPs 从 4K 上下文涨到 1M 只增长约四分之一。长上下文以前是奢侈品,现在接近标配件,成本曲线被压平了。552B 只是让这件事更难做,功劳不在参数上。
激活参数的配置也跟着改了。每个 MoE 层有 384 个路由专家加 1 个共享专家,每 token 激活 6 个路由专家,读输入时激活 8B,生成输出时激活 16B,两头不对称。另外挂了一张 196B 的 Engram 条件记忆表,靠 token 查表稀疏命中,独立于主干统计,所以 552B 这个数不能拿去估算部署显存。上一代 V4-Flash 主干 284B、每 token 激活 13B,对比下来这次是主干变大、激活变小。预训练用了 45T 多模态 token,稀疏注意力先在 64K 长度上训,到 34T 处把上下文拉到 1M。
视觉也是原生的。配了一个从零训的 DeepSeek-ViT 编码器,用 2D-RoPE 和 3 乘 3 的像素反洗牌下采样,接两层 MLP 投影,从预训练第一步起就和文本一起训。多模态评测里 MMMU-Pro 56.5、CVBench 77.9、DocVQA 95.6。上一代 Flash 是纯文本,要识图得另接一个 Vision-Exp 型号,这次一起下线了,旧名字暂时还解析得到,但没有旧模型的快照可用,也没有说这个临时路由什么时候结束。
调用时有个细节容易被忽略。推理强度不再只有开和关,而是一个 1 到 100 的旋钮,API 上暴露成 low、high、max,分别对应 50、75、100。官方那张基准表全部跑在 max 档,你按默认的 high 调,拿不到表上的分数。上下文 1M,最大输出 384K,单 user_id 并发 2500。
还有一处官方数字值得单独拎出来。DeepSeek 把同一个模型放进八套不同的 Agent 脚手架里跑,DeepSWE v1.1 上最高 74.2,最低 65.6,差 8.7 分。这个差距比同一张榜单上前几名模型之间的距离还大。厂商自报的 Agent 榜单里混着大量工具链因素,谁家的脚手架更顺手,分数就能高一截。以后看到这类表,先看脚注里的 harness 是什么,再看名次。这次还出现了一处文档对不上,changelog 里 NL2Repo-Bench 写 65.4,模型卡里写 64.0,两边没有校准。
速度方面,多家第三方博主和开发者实测的生成速度在每秒 420 到 427 token 区间,端到端吞吐约 409.5 tok/s,相对 V4 Flash Vision-Exp 的提速按任务类型从 3.9 倍到 6 倍不等。这些数是第三方跑出来的,不是官方数字,参考即可。生态侧,腾讯的 WorkBuddy、CodeBuddy 以及 OpenCode 已宣布接入。
想自己部署的人要先看清一件事。MIT 许可是真的,权重是真的,FP8 格式下总参数量接近 4846 亿,单机和消费级显卡跑不动,社区已经有 GGUF 量化版本,量化到能跑的规模之后还剩多少能力,没有公开数据。更现实的路线是调 API,顺便在 9 月 14 日之前用同一批文档、同一套工具定义和验收标准做一次回归,看看换成 Flash 之后你的任务到底变好还是变差。官方那句全面超越,放到你自己的任务上重跑一遍才算数。
支撑本文结论的来源
DeepSeek 官方 X 账号 9 月 10 日发布推文,Hugging Face 上 deepseek-ai/DeepSeek-V4.1-Flash 模型卡与技术报告,DeepSeek 官方定价文档与 9 月 10 日 changelog,腾讯新闻 2026 年 9 月 10 日 AI 大模型晚间速递。