两家欧美公司同一天抢着开源,可权重都要等下个月
10月5日,布鲁克林的Reflection AI发布了Beam,5010亿参数。第二天,巴黎的Mistral放出Large 4,1.05万亿参数,内部代号叫Le Chonk。两家都对外说自己是欧美最强的开源权重模型,两家也都说了同一句话,权重这个月晚些时候放。
我把能找到的材料对了一遍,包括两家自己的技术博客、TechCrunch和路透的报道。到10月7日为止,两个模型都还没有可下载的权重。Reflection给的是等待名单,Mistral给的是一个受限的公开接口,官方说的开权重时间是10月27日。
所以先把话说准。这轮发布目前发布的是参数表和作者自测,不是可以跑的东西。
先说Beam的账怎么算。它用的是稀疏混合专家架构,总共5010亿参数,但每生成一个token只激活其中230亿。Reflection在技术博客里强调的就是这个比例,同样的题目,它只让五十分之一的网络干活。训练侧的数字也大,预训练用了23.8万亿token,强化学习阶段动用10500块英伟达GB300,跑了四周,生成超过1亿次rollout。公司自己说这是开放实验室里规模最大的一次强化学习训练。
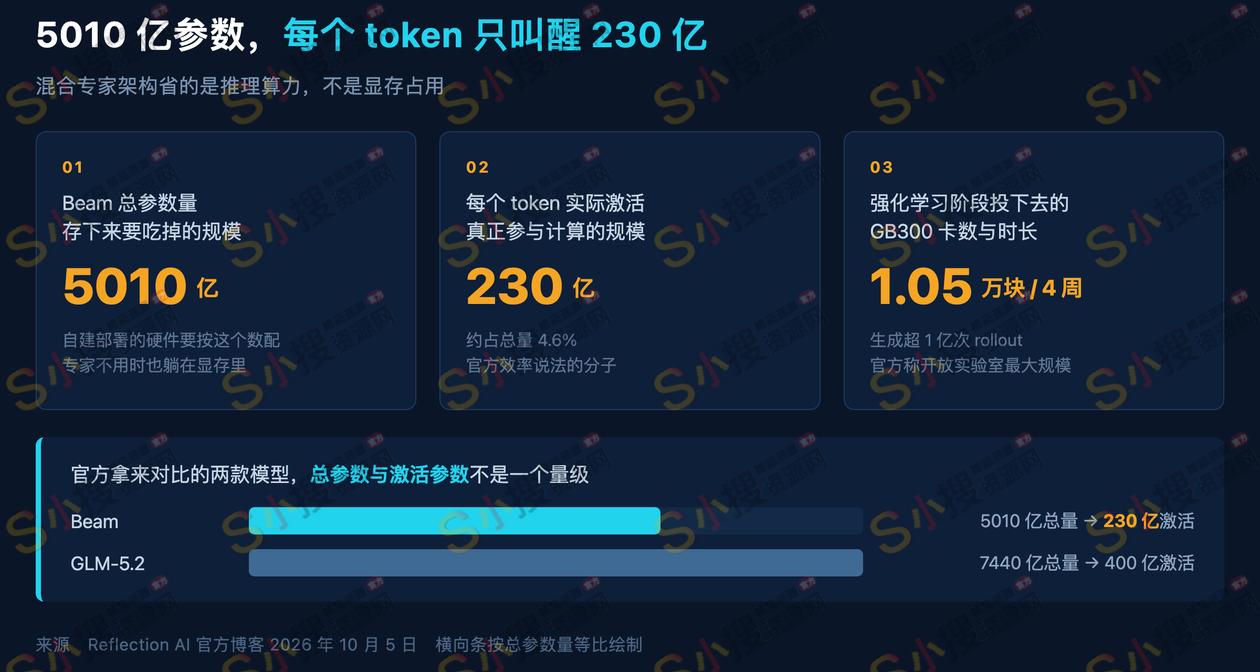
架构上省下来的那部分,是推理时的算力。存下来的部分省不了。混合专家模型的专家虽然每次只叫醒几个,但整批专家都得躺在显存里等着被叫。想自己在机房跑Beam,硬件还是得按5010亿参数配。Reflection自己讲效率的时候用的是每token的算力,不是整机成本,这两个数的量级差得很远。
现在看Beam自己公布的成绩单。在SWE-Bench Verified上它拿80.9分,Terminal-Bench 2.1拿80.1分,这两个位置不错。往下一格就不好看了。在DeepSWE 1.1这个跑真实软件工程任务的测试上,Beam得44.4分,智谱的GLM-5.2是44.0,而Kimi K3是68.0,DeepSeek V4.1 Flash是74.2。一个宣称自己是美国开源阵营代表、要跟中国模型掰手腕的模型,在它自己挑出来的表里,被两款中国开源模型甩开了二十多分。Reflection在博客里没有回避这一点,它写了Kimi K3在原始能力上仍然领先。
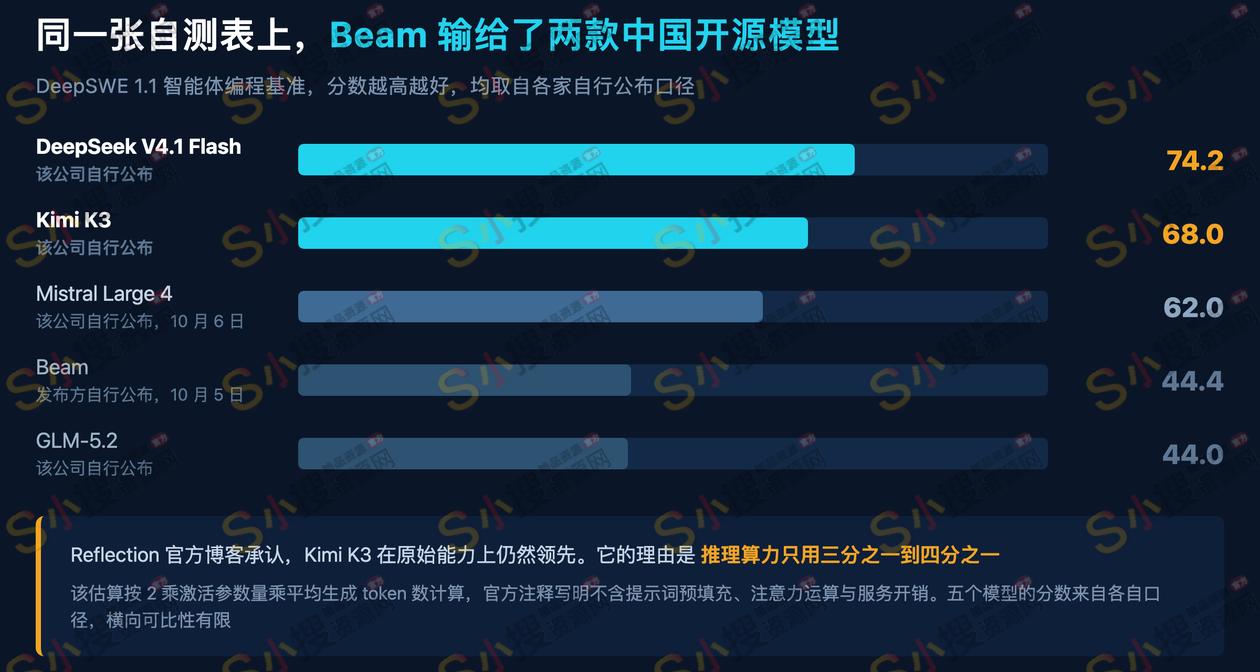
Beam的辩护是说它更省。官方口径是,高级推理上跟GLM-5.2持平,推理算力只用三分之一到四分之一。这个数字有出处,也有条件。Reflection的注释写明,它按2乘以激活参数量再乘以平均生成token数来估算,而且明确排除了提示词的预填充、随上下文变化的注意力运算和服务开销。所以那是个大致比较,不是实测出来的账单。我在意的正是这个差别。一个企业真要去买卡开服务,付钱按的是实测账单。
公司的钱和它的产品是配套的。Beam不要钱,Apache 2.0,下载了自己改。Reflection靠别的东西挣钱,官方管它叫AI工厂。银行和政府可以拿自家数据,在自家机房里,训它家的基座模型。它的钱来自机柜里的GPU。这层关系在股权上更直白,英伟达既投了Reflection大约8亿美元,又是GB300的供应商,公司整个夏天跟SpaceX和Nebius签了70多亿美元的算力合同,把芯片锁到2029年。免费给一个前沿模型是最好的鱼饵,每卖出一座AI工厂,就是卖出一批卡。
再看Mistral那一边。Large 4从零训起,用大约4000块英伟达Grace Blackwell,在欧洲自己的数据中心里训了两个月,耗电约10兆瓦。法国的实验室这次把欧洲自主做成了卖点,说客户要的是两样保证,没有外国能随时掐断访问,以及训练过程有一份说得清的记录。这话说得很有分量,但也要看它实际给出去的东西。10兆瓦是个什么量级,跟美国几家前沿实验室动辄上百兆瓦的园区不在一个档上。这也解释了Mistral为什么不去争总分第一,它的表里DeepSWE 1.1拿62分,比Beam高,但比Kimi K3低,而它更愿意谈的是网络安全、金融和芯片设计这几个具体场景。
把两家的声明放在一起看,会看到一件挺有意思的事。两家都把开权重的时间推到月底,理由也是同一个,要先做安全测试或者跟伙伴试用。放在三年前,开源模型发布就是当天把文件传上去。现在前沿规模的开源变成了一场分两步走的发布会,先放参数和分数,一个月后再放文件。我理解这个安排有它的道理,权重一出去就收不回来,红队测试需要时间。但读者读到的第一波新闻,读到的是参数和自测分数,那部分其实不需要等一个月。这中间的时间差,正好用来讲一个不用第三方验证的故事。
说了这么多不确定,也有能定的东西。Beam的出现确实填了一个空位。过去两年,最强开源模型的头衔基本在中国实验室手里,Qwen、DeepSeek、Kimi、GLM轮着坐。现在有一家美国公司愿意把自己的前沿模型按Apache 2.0放出来,这是好事,尤其对那些不能把数据送进API、又不想用中国模型的企业。Beam值不值得上生产,答案很具体,就等文件放出来,谁拿自己仓库里的真实问题跑一遍,谁才知道。在那之前,它是一份参数表加一份自测成绩单。
来源
Reflection AI官网10月5日那篇Beam介绍,含参数、训练规模、基准表与效率估算方法注释;TechCrunch关于Beam的报道,涉及融资约47亿美元、投后估值约250亿美元、SpaceX与Nebius算力合同、英伟达持股约8亿美元;The Next Web与BlockBeats对Mistral Large 4预览版的报道,含4000块Grace Blackwell、两个月训练与10兆瓦功耗;IT之家对Beam发布的中文报道。