722 篇数学稿一次放出,请来把关的顾问组说别再这么干
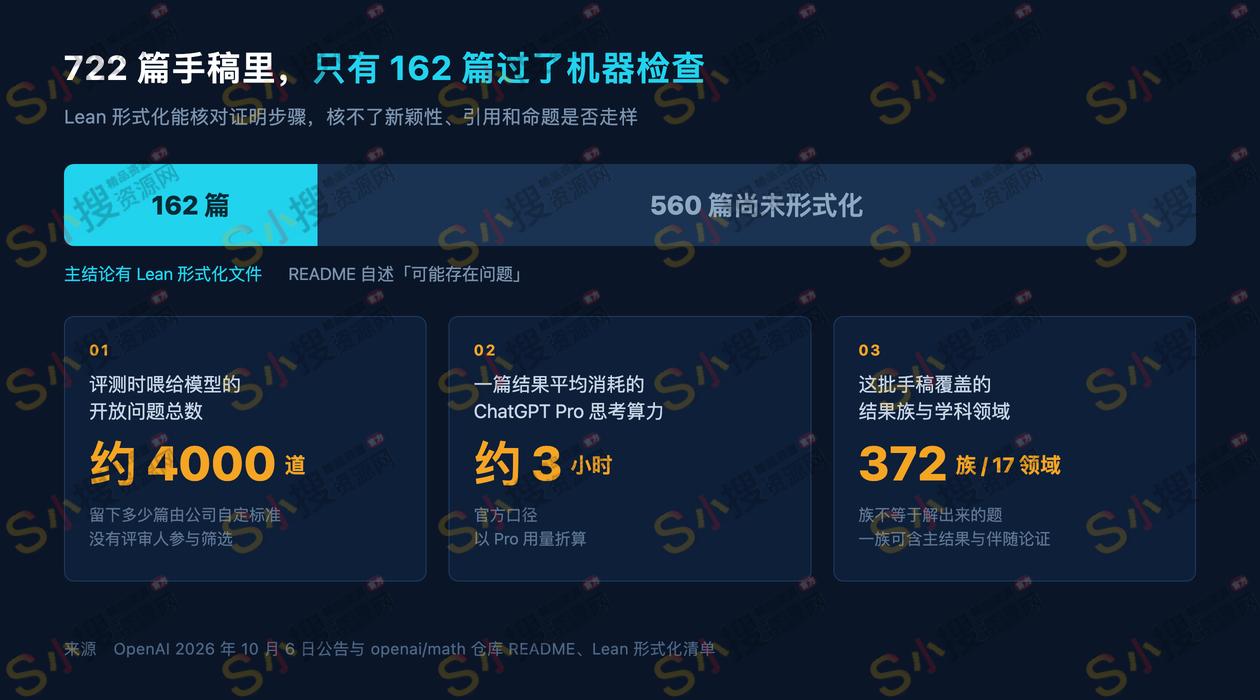
10月6日,GitHub 上多了一个叫 openai/math 的仓库。里面是 722 篇数学手稿,按 372 个结果族归类,跨 17 个领域。OpenAI 的公告说,这些稿子出自一个内部前沿模型,模型暂不发布。评测期间模型一共拿到约 4000 道开放问题。公司挑出认为够格的留下来,整理成族,再拆成手稿。一篇结果平均要跑掉约三小时的 ChatGPT Pro 算力,这是官方口径。
手稿分两档。162 篇的主结论配了 Lean 形式化文件,Lean 是能把证明写成代码、再让计算机逐行核对的证明助手。剩下 560 篇没有。README 自己写着,没形式化的那些可能存在问题。OpenAI 承诺陆续补上,也保留了版本历史,勘误以新版本记录,旧版仍然可以访问。
说 Lean 能证什么,值得花两句。代码里写下的那条命题是否成立,它负责核对。结果新不新、重不重要、有没有引用前人、形式化出来的命题跟论文里的说法算不算同一件事,它一概不管。一篇稿子过了 Lean,跟这篇稿子在数学上站得住,中间还隔着不少东西。
没有形式化的那份名单里,有几条是这次的主打。所有非交换自由群因子同构,π 的无理性指数正好是 2,有理数上的希尔伯特第十问题被给出了否定回答,这三条都还只在纸面上。反过来,Dirichlet L 函数在 Re(s) 大于八分之七的半平面内无零点、对称马勒猜想、Kaplansky 零因子猜想的反例,这几条的主结论有形式化文件。八分之七讲的不是黎曼猜想,黎曼猜想要的是二分之一那条线,这里是另一个更弱的界。
数字也要分清楚。372 个结果族不等于 372 道解出来的题,一个族里可能有主结果、伴随论证、推论和另一种证法。哪些结果够格进来,标准是 OpenAI 自己定的。约 4000 道题和 722 篇稿子放在一起可以算出个比值,但题目难度不一样,这个比值说明不了通过率。OpenAI 也发布了十份推理摘要,覆盖二乘法函数的两点关联、马勒猜想、稀释自旋玻璃的 Mézard-Parisi 公式、量子海森堡铁磁体的自发磁化这些条目。
公告提到这次发布参考了普林斯顿高等研究院的数学与 AI 顾问组(AGMAI)的建议。这个组 9 月 21 日成立,九名成员里有 Timothy Gowers、Martin Hairer、Ravi Vakil、Edward Witten 和 Melanie Matchett Wood,都不领报酬。9 月 29 日他们发布《AI 生成数学成果的负责任发布》,依据是六百多份社区回复。
文件开头不客气。原文写着,目前一些前沿实验室正在把高等数学问题放在社区访问不到的专有模型上测试,他们不认可这种做法,并要求停止。后面的条目更细,成果要存进不受 AI 公司控制的学术库并带持久标识,每项结果要公开模型名称、提示词、思维链摘要、耗时和算力成本估算,还要交代一共有多少题没做出来。
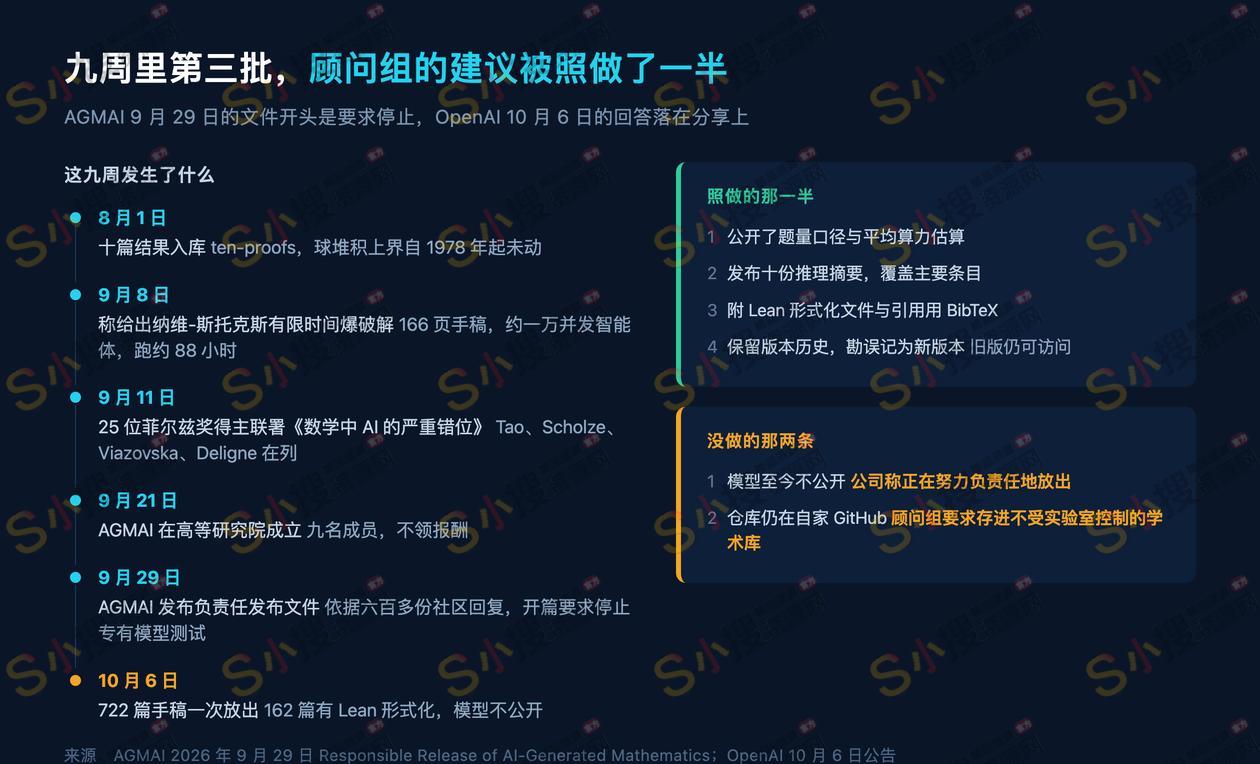
OpenAI 照做了一部分。题量、算力口径、十份推理摘要、Lean 文件都给了,引用用的 BibTeX 也配了。没做的有两条,模型不公开,仓库仍在它自己的 GitHub 上。公司说要探索符合顾问组要求的社区托管方案。
我认为会长期起作用的是发布工艺这一块。一个能核验的局部,被做成了整套交代,谁想复核,能动手的是那 162 份形式化文件,其余 560 篇连机器检查都没有。这比前面几批收拾得干净,但这些结果是否成立,还得有人一篇一篇读过去。
九周里这已经是第三批。8 月 1 日先有十篇,放进 openai/ten-proofs,其中一条改进了球堆积的上界,那个上界从 1978 年起没动过。9 月 8 日的动作更大,公司称内部模型给出了纳维-斯托克斯方程的有限时间爆破解,配了 166 页手稿和一份 57 页的欧拉方程伴随稿。科技媒体 VentureBeat 当时报道,那次动用了大约一万个并发智能体,跑了约 88 小时。
真正的反弹发生在 9 月 11 日。25 位菲尔兹奖得主联署声明《数学中 AI 的严重错位》,Terence Tao、Peter Scholze、Maryna Viazovska、Pierre Deligne 都在名单上,签名之后还在增加。他们没有说证明算错了。他们提出的是另一件事,解出难题原本只是通往理解的手段,把解题这一项优化到底,领域里积累的答案就会多过积累的理解,署名和优先权那套老规矩也会跟着失灵。
这个担心有具体例子。据 Scientific American 核查,8 月那十篇里有两篇用了已发表的想法而没妥善引用,而公司当初对这些问题的说法是主结论十年没有进展。纳维-斯托克斯那边更麻烦,纽约大学的 Tristan Buckmaster 对 TechCrunch 说,OpenAI 施压不让他把合作者 Levent Alpöge 列为共同作者,Alpöge 在 Anthropic 工作,两人当时用包括 Codex 在内的工具各自追同一个问题。OpenAI 否认直接取用两人的未公开工作,同时承认无法排除从去标识化的使用数据中间接受益。
我留意到顾问组那句要求指向的是测试,OpenAI 的回答指向的是分享。公司对 Gizmodo 说的是,顾问组的建议影响了他们分享这些结果的方式。模型至今没有放出来,这个缺口没有被回答。
反面的意见也有分量。多伦多大学的 Daniel Litt 认为公开比保密好,理由是既然想知道答案,没道理让实验室藏起来。Gowers 也讲过,先前某一份证明他会毫不犹豫推荐给顶刊。这两种态度跟前面的批评不冲突,矛头对着的是发布方式。
荷兰那份《莱顿宣言》的签名数学家已经超过四千人,要的是 AI 公司遵守开放、署名与验证上既有的标准。顾问组九人里签过 9 月 11 日那份声明的只有 Camillo De Lellis 一个,这一点常被用来质疑这个组的独立性。这个组也没有权力叫停任何发布,高等研究院的公告写得很清楚,决定权在各自公司手里。
来源
OpenAI 10 月 6 日公告 Sharing AI progress in mathematics,以及 openai/math 仓库的 README、总览目录与 Lean 形式化清单;AGMAI 9 月 29 日 Responsible Release of AI-Generated Mathematics;25 位菲尔兹奖得主 9 月 11 日声明 A Severe Misalignment of AI in Mathematics;Scientific American、TechCrunch、Gizmodo 与 VentureBeat 的相关报道。