AI诊断83%对36%登《科学》,论文里写着它花得更多
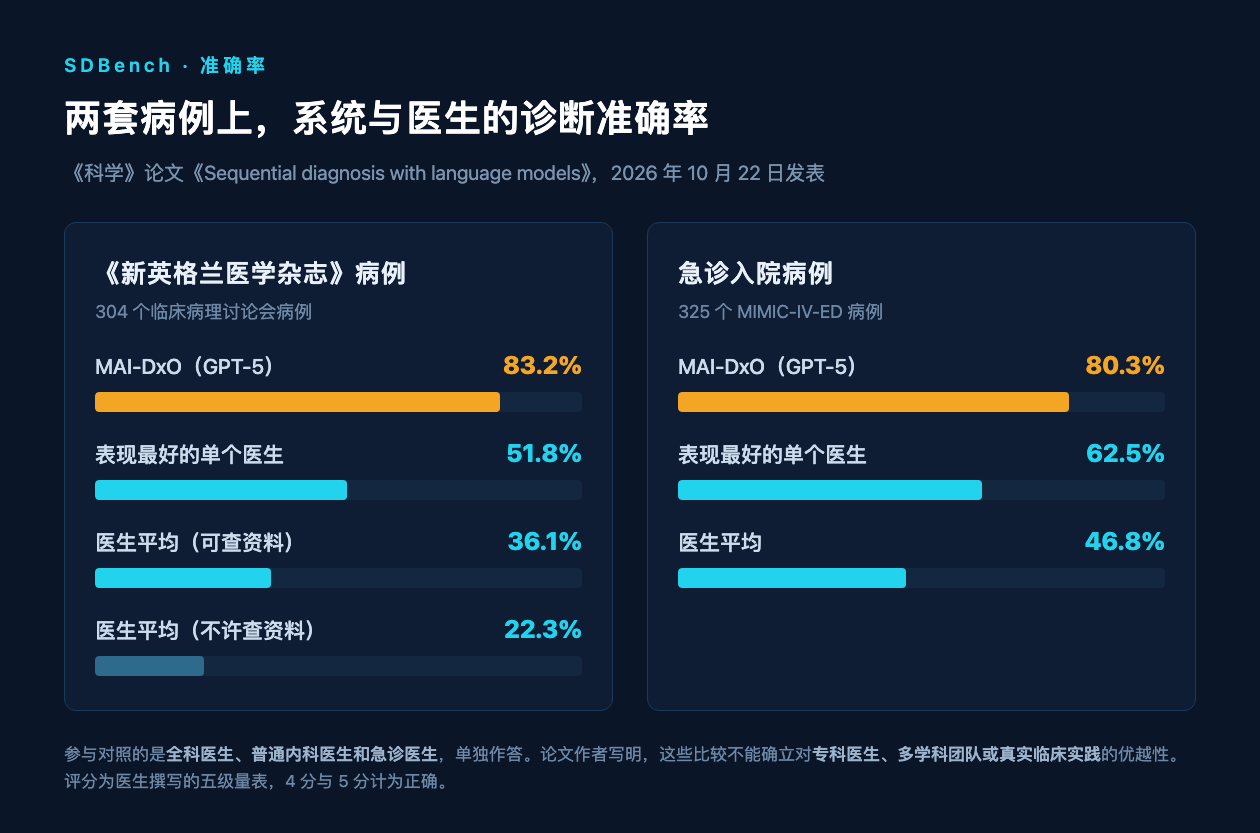
微软这套叫 MAI-DxO 的诊断系统,10 月 22 日在《科学》上有了正式论文。论文里最显眼的一组数字是 83.2% 对 36.1%。前一个数是系统在 304 个《新英格兰医学杂志》临床病理讨论会病例上的诊断准确率,后一个数是医生的平均成绩,这些医生可以查教科书,也可以上网。
36% 看着低得离谱,要看清它怎么来的。这批病例是 NEJM 的 CPC 病例,本来就是挑出来给同行看的疑难杂症,临床上通常会交给专科医生或者多学科会诊。参与对照的是全科医生、普通内科医生和急诊医生,一个人单独作答,没有同事可问。论文作者自己写了这样一句,这些比较不能确立对专科医生、多学科团队或真实临床实践的优越性。
同一批医生不许查资料的时候,平均分掉到 22.3%。表现最好的单个医生拿到 51.8%,仍然低于系统,花的钱也比系统多。这个 51.8% 我记下来了,它说明 36.1% 是平均值,不是医生这个群体的天花板。
微软在官方博客上写的另一句话是成本降到一半甚至三分之一。翻到论文里的账,情况和这句话不完全一样。不设预算上限时,MAI-DxO 在每个 NEJM 病例上平均花掉 5,431 美元的模拟检查费,带着资料看病的医生是 4,725 美元。系统比人花得多。
省钱的版本要靠加约束。研究者给系统压了预算,得到一个 80.9% 准确率配 2,241 美元的配置,再压一点是 79.6% 配 1,303 美元。准确率从 83.2% 掉下来,钱才省下去。博客里那句一半甚至三分之一,指的是这类加了预算的配置跟对照系统比。
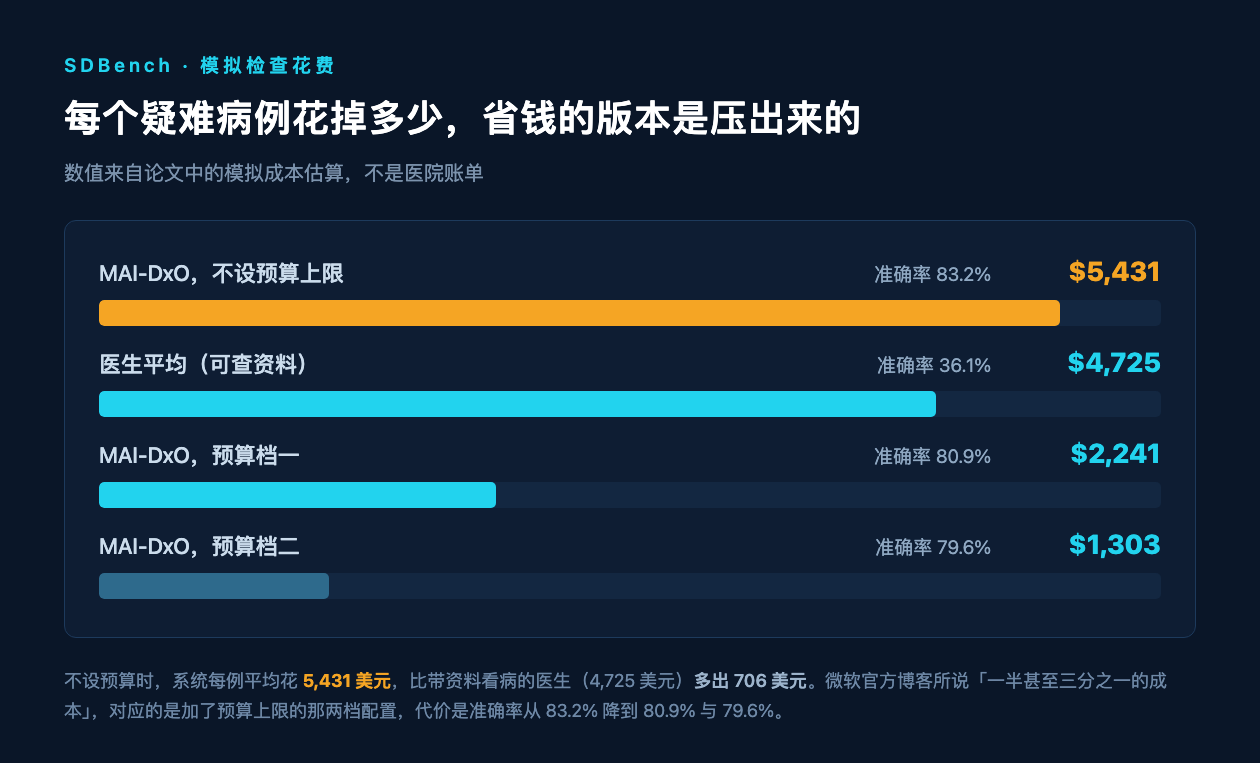
我的判断是,省钱的说法和数据之间有缝,缝不宽,方向却是反的。微软那句「在两组数据上,没有其他人类或 AI 方案同时做到更准且更便宜」本身站得住,只是它没说清楚更便宜是压出来的,不是自然发生的。这些成本数字来自模拟器估算,不是医院账单,论文也这么标注了。
急诊那一组的结果可以做个对照。325 个 MIMIC-IV-ED 的急诊入院病例上,系统 80.3%,医生平均 46.8%,医生这组平均花 3,400 美元,最好的单个医生是 62.5%。难度降下来之后,差距从两倍多收窄到 1.7 倍。
那 83.2% 里有多少是编排器的功劳,是我看这篇论文时最想知道的一件事。MAI-DxO 的做法是让一组虚拟医生开会。有人负责提诊断假设和挑检查,有人专门反驳已经形成的看法,每一步检查的价钱则由另一个角色放进权衡。信息一次给不全,系统从一小段主诉开始,自己决定下一步问什么、开什么检查,由一个叫 Gatekeeper 的模型按真实检查能透露的范围逐条放信息,最后由 Judge 模型按一份医生写的五级评分表判分,4 分和 5 分才算对。
论文给出的增量是,在最小提示的基线上,这套编排平均把讨论会病例的准确率提高 7.9 个百分点,急诊病例提高 4.4 个百分点。系统跑在 GPT-5 上,换成 GPT-5.5 之后不改提示词、不改编排方法重跑一遍,优势反而变大。微软还测过 o3、Gemini、Claude、Grok、DeepSeek 和 Llama。
我的第二个判断是,这套东西真正值钱的产出是 SDBench 这个评测办法,还有微软愿意把让自己数字变小的那一组印进论文。编排层能加多少分,随底层模型变化很大。TechCrunch 的读法是,普通急诊病例上前沿模型裸跑的分数跟编排后的结果差不多。一年多前的预印本里,医生那组是不能查资料的,MIT 的 David Sontag 当时对 Wired 说这个结果要谨慎看待。正式发表的版本补上了能查资料的医生组,接住了那条批评的一半,代价是倍数从四倍多降到 2.3 倍。微软把这个更小的倍数印了出来。
开放的部分也留了门槛。微软把 SDBench 的基准、Gatekeeper、Judge 和成本估算代码以 MIT 许可放到了 GitHub。不过 NEJM 那批病例要向 NEJM Group 申请授权,MIMIC 那份要走 PhysioNet 的资格审核,能直接跑的公开数据是五个完全合成的病例。想用这套题去检验专科医生的水平,门开着,门槛还在。
论文的披露栏里,全部作者都是微软员工并持有公司股票,其中八人是一项相关专利申请的共同发明人,研究没有拿微软之外的钱。评审和打分的代码是微软自己写的,病例是微软挑的,对照医生是微软找的。这些条件单独看都不构成问题,放在一起才是读那个 83.2% 时该有的背景。
接下来要看波士顿的贝斯以色列女执事医疗中心。微软说会在那里做前瞻性研究,让真实患者跟系统直接打交道,系统的判断跟医生的独立评估对照。微软 AI 健康业务的企业副总裁 Dominic King 对 The Verge 说,这项研究大概一两个月内启动。同一家医院这个月已经出现过一次类似的事,谷歌 10 月 8 日公布的 AMIE 研究里,98 名患者在就诊前先跟系统聊过,系统给出的鉴别诊断有九成与最终诊断吻合。
Mustafa Suleyman 本周对 The Verge 的说法是,它还需要临床验证,那是一步跨越,但这是这条路上的一个重要里程碑。这句话的分寸比医疗超级智能那个提法稳。
这篇论文最实在的一句也许藏在方法部分。评分表把 4 分和 5 分算作正确,而这两个分数对应的定义是处理方式不会因此改变。诊断对不对,最后要落到治疗方案动不动。这一点在模拟器里测不出来。
来源
《科学》论文《Sequential diagnosis with language models》(10 月 22 日,DOI 10.1126/science.aeh7930)、微软 AI 官方博客《Building Medical Superintelligence》(10 月 22 日)、TechCrunch 与 The Verge 对 Dominic King 和 Mustafa Suleyman 的采访、Unite.AI 与 DailyAI 对论文数字和披露栏的转述。