25 个游戏都打到满分,70 万美元大奖为什么还没人领
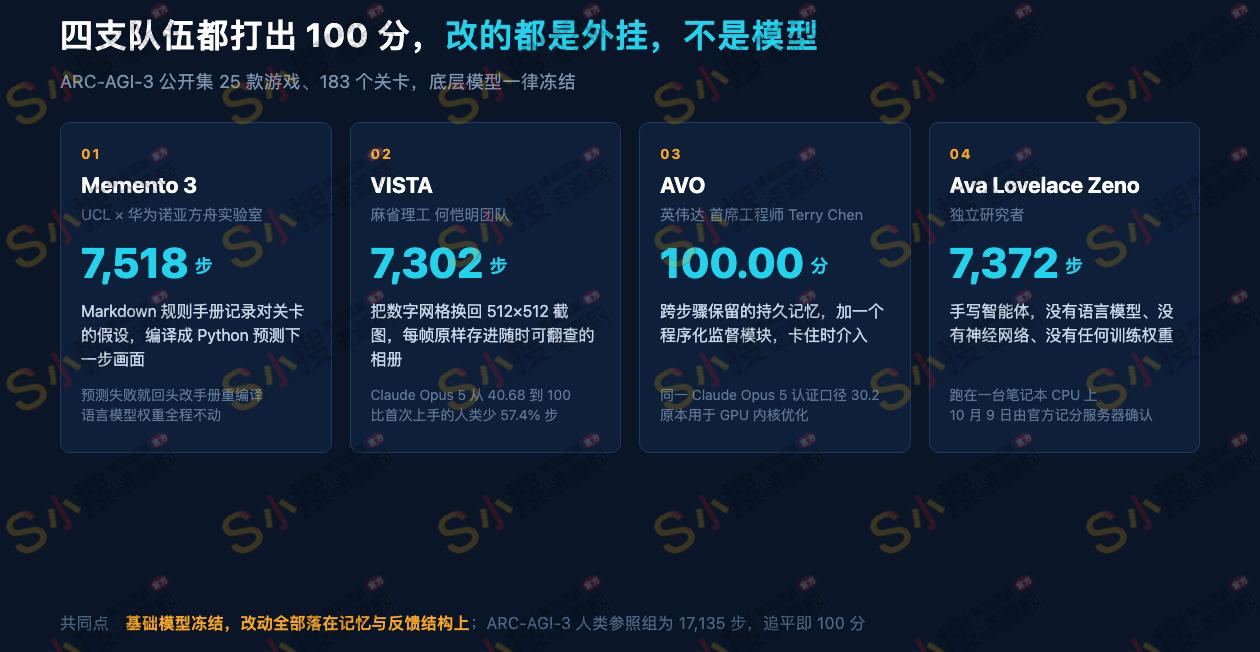
10 月 9 日,ARC Prize 的记分服务器上多了一条成绩。一个叫 Ava Lovelace Zeno 的智能体打完了 ARC-AGI-3 全部 25 个公开游戏、183 个关卡,用掉 7,372 步,人类参照组是 17,135 步,服务器给出的分数是 100.0。这条记录特别的地方在它的构成。它没有语言模型,也没用神经网络,智能体本身没有任何需要训练的权重,跑在一台笔记本的 CPU 上。
同一个月里,同样打到 100 分的还有三支队伍。
伦敦大学学院和华为诺亚方舟实验室的 Memento 3,10 月 8 日挂上 arXiv(2610.11794)。它的核心是一份用 Markdown 写的规则手册,记录智能体对当前关卡的理解,再把手册编译成 Python 程序,用来预测下一步画面会变成什么样。预测和实际不符,就回头改手册、重新编译。整个过程中,底层语言模型的权重没有更新过一次。论文报告的成绩是 25 个公开游戏全部满分,7,518 步。
麻省理工何恺明团队的做法叫 VISTA,论文 10 月 1 日已经在 arXiv(2610.02200)上,中文技术圈到 10 月 10 日前后才大面积讨论。它抓住的是另一个环节。此前的官方接口把画面压成 64×64 的数字网格递给模型,一帧大约 4,000 个 token。VISTA 直接把 512×512 的游戏截图交给多模态模型,再把每一帧原样存进一个随时可以翻查的相册,截图一帧大约 300 个 token。同样是 Claude Opus 5,官方基线 40.68 分,加上 VISTA 之后是 100 分,通关全部 25 个游戏,7,302 步,比首次上手的人类少 57.4%。换成 GPT-5.6 Sol,分数从 13.33 升到 99。团队还做了反向的对照,把上下文窗口从 20 万 token 撑到 78 万,消耗的 token 大幅增加,成绩反而从 99 掉到 93.9。
英伟达的系统叫 AVO,全称 Agentic Variation Operators,团队负责人是首席工程师 Terry Chen。它用的 Claude Opus 5 在官方认证口径下只有 30.2%,裹进 AVO 之后同样拿到 100.00。AVO 提供两样东西,跨步骤保留的持久记忆,以及一个程序化的监督模块,在搜索卡住的时候介入。它原本是做 GPU 内核优化的,换到交互式推理上,核心循环没有改动。
四份成绩摆在一起,最容易得出的结论是模型忽然变聪明了。这四支队伍做的事情里,没有一件是在提升基础模型的推理能力,全部集中在同一件事上,给模型配一个更好的记忆和反馈结构。英伟达自己把结论写在发布说明里,系统设计本身就能解锁长程任务上的前沿级表现。OpenAI 在 7 月做过一组更干净的对照,模型一律不动,只改两处框架配置,同一张卷子的分数涨到 4.9 倍。
要看清楚这批满分,得先弄清楚卷子的结构。ARC-AGI-3 由 ARC Prize 基金会 2026 年 3 月 25 日发布,创始人是 Keras 作者 François Chollet 和 Zapier 联合创始人 Mike Knoop。它的 135 个环境分公开集、半私有集和完全私有集三档,公开集可以被人反复研究。发布当天官方给出的数字是,人类解出 100%,所有前沿模型加起来 0.51%。评分用的是相对人类行动效率,英文缩写 RHAE,看智能体完成一个关卡用多少动作,和人类中上水平的参照组比,追平就是 100 分,这是这个指标给出的上限。
官方认证榜采用统一的 Standard 测试框架,对所有厂商一视同仁。目前排在最前面的是 GPT-6 Astra 的 62.7%,GPT-6.1 Sol 52.7%,Claude Opus 5 停在 30.2%,上一代 GPT-5.6 Sol 7.8%。前面那份 30.2% 对应的 100 分出现在另一条赛道,叫 Provider Adapter,允许模型在步骤之间保留厂商自己的推理状态。同一个模型、同一批游戏,两套框架给出的分数差了将近 70 分。这中间的落差,来自考场允许考生带多少草稿纸。
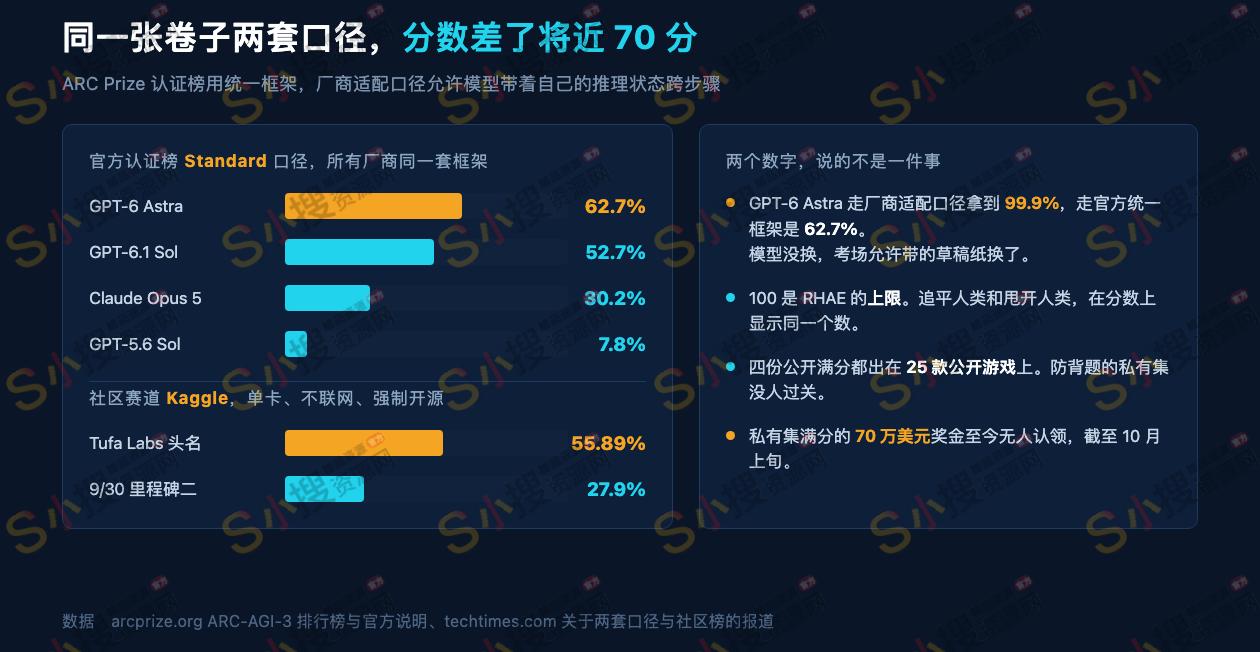
社区赛道的规矩又是另一套。Kaggle 上的比赛不给联网,只分配一块 GPU,还要求参赛者先把方案开源、再拿私有集分数。这些限制逼着人往轻量、可复现的方向做,也解释了一支 27B 参数的开源模型为什么能压过一堆闭源旗舰。
这批满分的实际含义,是评测本身在贬值。RHAE 以 100 为上限,追平和超越在分数上无法区分,一个刚好达标的系统和一个大步甩开人类的系统会显示同一个数字。所有公开满分都出在 25 个公开游戏上,而设计用来防背题的是私有测试集,那 70 万美元奖金对应的正是私有集上的 100%。截至 10 月上旬,这笔奖金无人认领。社区榜的头名是 Tufa Labs,10 月 4 日拿到 55.89%,比 9 月 30 日里程碑二的 27.9% 高出一倍。撑起这个成绩的模型没有换,换的是外面那层框架。最终提交截止 11 月 2 日,获奖名单 12 月 4 日公布。
ARC Prize 基金会对这个局面有自己的说法。官方在一份说明里把框架改进带来的收益称为进一步的任务自动化能力,认为它可以产生经济价值,但不必然代表朝向通用智能的进展。这话说得克制,也把问题留给了读的人。一份以刷不动为卖点的卷子,公开部分在两个多月里被四拨人打穿,它自己的认证榜还停在 62.7%。这半年更值得留意的一条信息是记忆和反馈结构能把同一个模型的分数翻几倍,这部分工程量能自己攒。
来源 arXiv 2610.11794、arxiv.org/abs/2610.02200、arcprize.org 的 ARC-AGI-3 页面与排行榜、developer.nvidia.com 的 AVO 说明、Zenodo records/23269727、techtimes.com 关于两套评测口径与社区榜的报道。