算力还在涨价,AI 的思考一年便宜到十三分之一
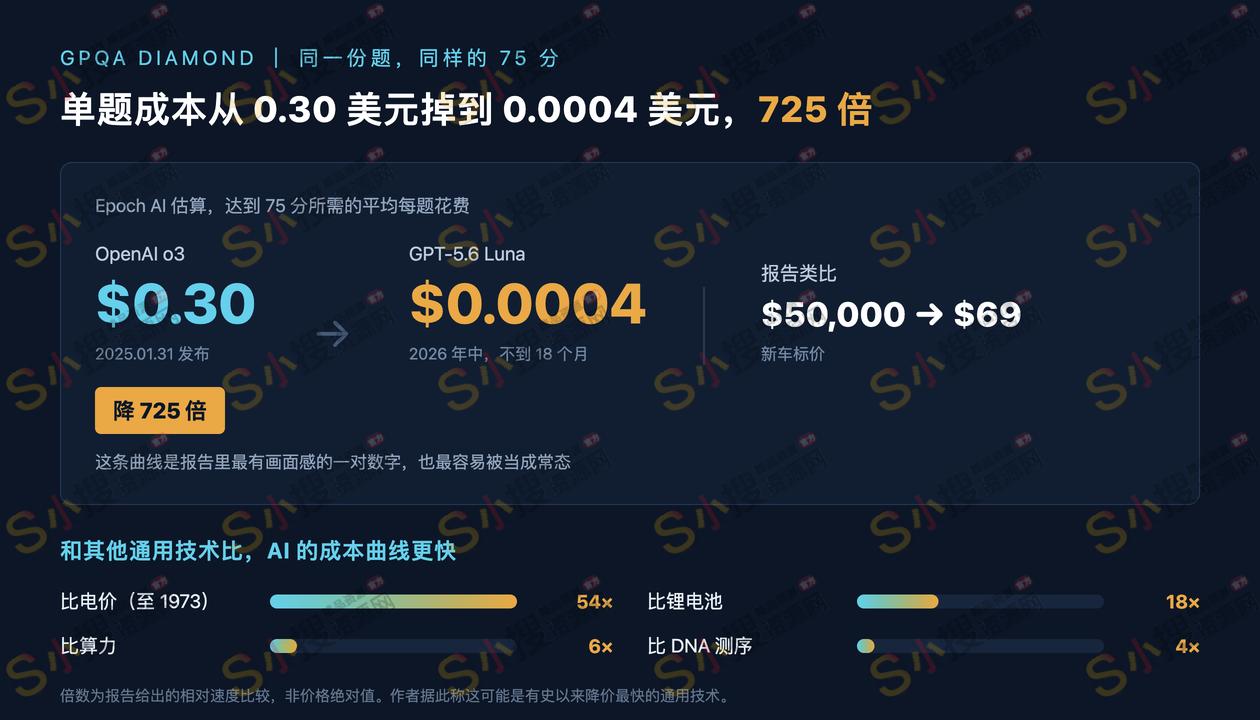
2025 年 1 月 31 日,OpenAI 发布 o3。按 Epoch AI 的估算,要让这个模型在 GPQA Diamond 上拿到 75 分,平均一道题要花 0.30 美元。GPQA Diamond 是一份博士级的物理、化学、生物多选题。
不到 18 个月之后,OpenAI 的 GPT-5.6 Luna 在同一份题上拿到同样的 75 分,每题 0.0004 美元。价格掉了 725 倍。Epoch AI 给的比方是一辆标价 5 万美元的新车,现在卖 69 美元。
这两行数字出自 9 月 22 日 Epoch AI 发布的报告《The plunging price of thought》,作者是 Luke Emberson 和 David Roodman。报告的结论是,过去三年,达到同一水平的 AI 性能所需要的成本,平均每个季度下降约 47%,换算下来一年约 13 倍。这个数字来自他们数据最完整的五个基准,另外附了一些更早数据的粗略分析。
47% 这个数得先讲清楚它测的是什么,不然很容易读错。它测的东西和价格表上那一行不一样。大家平时比的是每百万 token 报价,报告问的是另一件事,想要某个确定的性能水平,最少要花多少钱。
做法是画一条成本前沿。对每个模型,在每个推理档位和每个 token 预算下,都能得到一个性能与花费的配对。把所有模型的这些点铺在同一张图上,取给定性能下最便宜的那个,就得到前沿。难点在于,很多模型只在某个固定推理强度下被跑过,预算收紧之后会怎样没人测过。
他们借用的是美国联邦机构 Center for AI Standards and Innovations 的方法。基准由一批题目组成,跑完会留下每道题花了多少 token、有没有答对的记录。有了这份记录就能反推,假如规定每题只许用 X 个输出 token,那些在 X 以内答完并且答对的题有多少,超时的题按猜对的概率算,四选一就算 0.25。把 X 从紧到松扫一遍,就得到一条性能对花费的曲线。Epoch 另外补跑了一批开放权重模型,自己跑的成本和 API 价格的偏差在 30% 以内。
五个基准分别是 AIME 的 OTIS Mock 卷(数据从 2023 年 3 月起)、国际象棋谜题(2023 年 6 月)、FrontierMath 第 1 到第 3 级(2023 年 11 月)、GPQA Diamond(2023 年 3 月),还有一个身份保密的游戏谜题集(2023 年 6 月)。分类不同降速也不同,数学题每季度降 50% 到 52%,棋类和游戏慢一些,39% 到 43%。
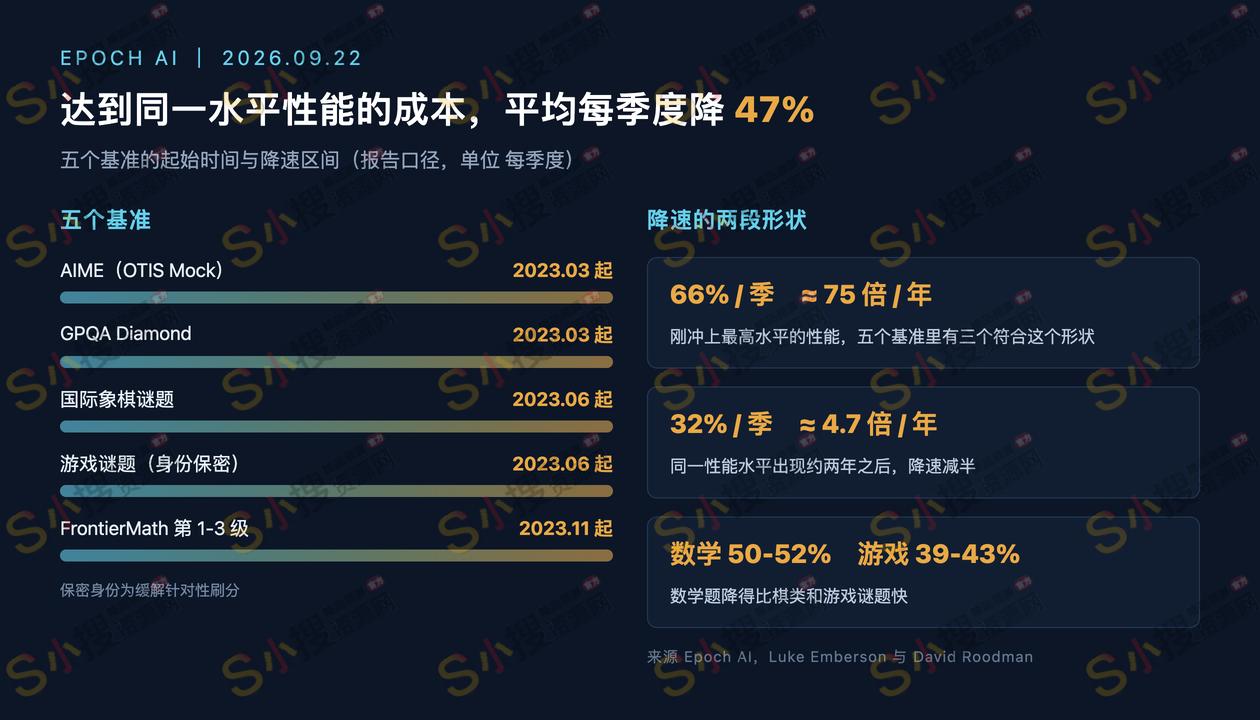
我第一个判断是,把 47% 当成一条会一直延伸下去的直线,账会算错。依据是报告自己给出的分段。刚冲上最高水平的性能,成本每季度降 66%,一年 75 倍;等两年过去,降速减半,每季度 32%,一年 4.7 倍。五个基准里有三个符合这个形状。也就是说新能力刚被证明可行时最贵,两年后基本跌到底。要排预算的人照这个形状排,比照一个平均值排靠谱得多。
同一天发生的两件事可以给这条曲线做个注脚。9 月 22 日 OpenAI 给 GPT-6 系列加了 Sol 和 Luna,Sol 定价每百万输入 2 美元、输出 10 美元,Luna 是 0.10 和 0.50 美元,都是上一代 GPT-5.6 对应版本促销价的一半。大约 90 分钟后 Anthropic 发布 Opus 5.5,定价 4 和 20 美元,缓存读取价从 0.5 美元降到 0.2 美元。两家前后脚降价这件事,用开放权重模型的压力来解释比用善意解释更顺。
报告也把这条曲线和其他通用技术放在一起比,比 1973 年之前的电价、比算力、比锂电池、比 DNA 测序分别快 54 倍、6 倍、18 倍、4 倍。作者据此认为,这可能是有史以来降价最快的通用技术。
我第二个判断是这条曲线不等于 AI 的账单会变小。依据同样在报告里。他们举的例子是这样,把几千篇科学论文里的错误挑出来,需要的认知量相当于把这类基准跑一百万次,就算一次只花一分钱,总账照样很大。而且价格往下走的同时能力还在往上走,通过一年级数学题现在几乎不要钱,证明困难定理仍然贵。省下来的钱会不会变成更多的调用,报告没有给答案。
这大概也是报告结尾那个矛盾说法的来处。AI 热潮把投入品的价格往上推,芯片和电力都在涨,而数据中心产出的价格在暴跌。两件事可以同时成立。
我第三个判断是 47% 这个数本身的精度要打折。依据是他们自己写的限定。他们没有给自助法置信区间,理由是标准重采样对成本前沿不适用,前沿只能往里缩不能往外扩;Simar 和 Wilson 在 1998 年提出的替代方案要求低效率分布同质,而 2023 到 2026 这段时间里前沿移动很快、参与的模型越来越多、采样越来越全,这个假设很可能不成立,硬算出来的标准误会虚假精确。
平均怎么取也很敏感。GPQA 用四种精度网格方式算,结果在每季度 42.9% 到 58.0% 之间。报告选的是均匀精度并裁剪掉 SOTA 段,得到 47.0%。换一种取法,这个数字能差出十几个百分点。
剩下三条限定同样写在报告里。基准可能被专门训练去刷分,他们把其中一个游戏基准的身份保密来缓解,那个基准的降幅是 44.0%(模型无关口径)和 38.7%(Box-Tidwell 口径),比平均值低,说明刷分的批评站得住,但没有把结论推翻。基准分数也不等于有用的市场价值,电和电池有直接的市场价格,AI 的分数没有。另外只有三年数据,时间窗短。
最后一条跟读到这里的人最有关系。报告明说,几乎没有用户会一直待在成本前沿上,不停地换模型。真实团队有工作流、有迁移成本、还要考虑稳定性。一个模型在纸面上便宜很多,不等于明天就该把全部调用切过去。
报告的数据和代码都放在 GitHub 上,愿意复核的人可以自己去跑。
支撑本文结论的主要来源,Epoch AI 报告《The plunging price of thought》(Luke Emberson 与 David Roodman,2026 年 9 月 22 日,epoch.ai),以及 TechCrunch 对 GPT-6 Sol、Luna 和 Claude Opus 5.5 发布的报道。