开源权重首次逼近闭源,Kimi 降价三成后每单只省两美分
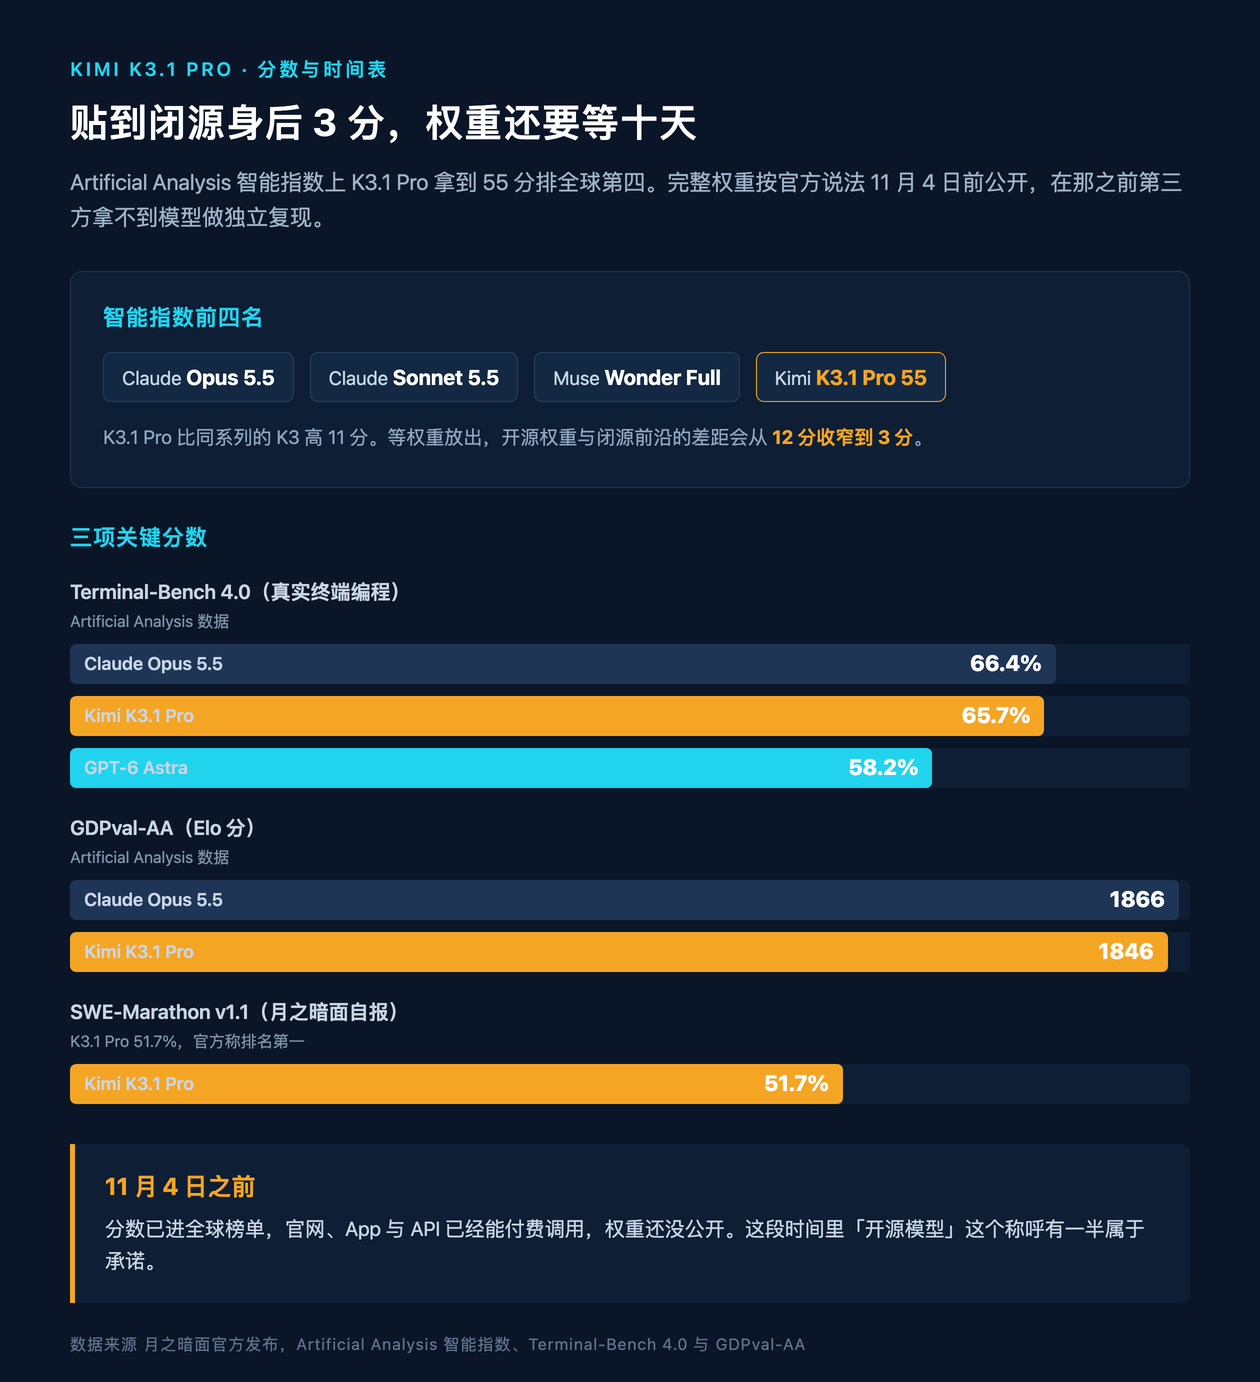
10 月 24 日凌晨,月之暗面把 Kimi K3.1 Pro 放了出来。同一天 Artificial Analysis 的智能指数榜上多了一个 55 分,排在第四,前面是 Claude Opus 5.5、Claude Sonnet 5.5 和 Muse Wonder Full。55 分这个数字本身没什么戏剧性,戏剧性在于它离第一名的 Claude Opus 5.5 只差 3 分,而 K3.1 Pro 的完整权重按官方说法会在 11 月 4 日前公开。等权重真放出来,它会成为这个榜单上分数最高的开源权重模型,开源和闭源之间那条 12 分的沟会被填到 3 分。
先把价格的事说完,这是这次发布里最容易被传错的一处。API 定价从 K3 的每百万 token 输入 3 美元、输出 15 美元,降到输入 2 美元、输出 10 美元,三项费率各降了约三分之一。国内人民币报价是输入 13 元、输出 68 元,官方给的说法是输入降 35%、输出降 32%。另有 Highspeed 版,输出速度是标准版的 2 到 3 倍,价格翻倍。
降价三成听起来是一次很实在的让利。Artificial Analysis 按自己榜单的口径算出来的结果却不是这样。它给 K3.1 Pro 算的单任务成本是 1.98 美元,K3 是 2.00 美元,两代模型几乎持平。原因是 K3.1 Pro 每完成一个榜单任务要生成大约 5.5 万个输出 token,比 K3 多 14%。单价便宜了三分之一,吐出来的字数多了一成半,乘下来账单几乎没动。
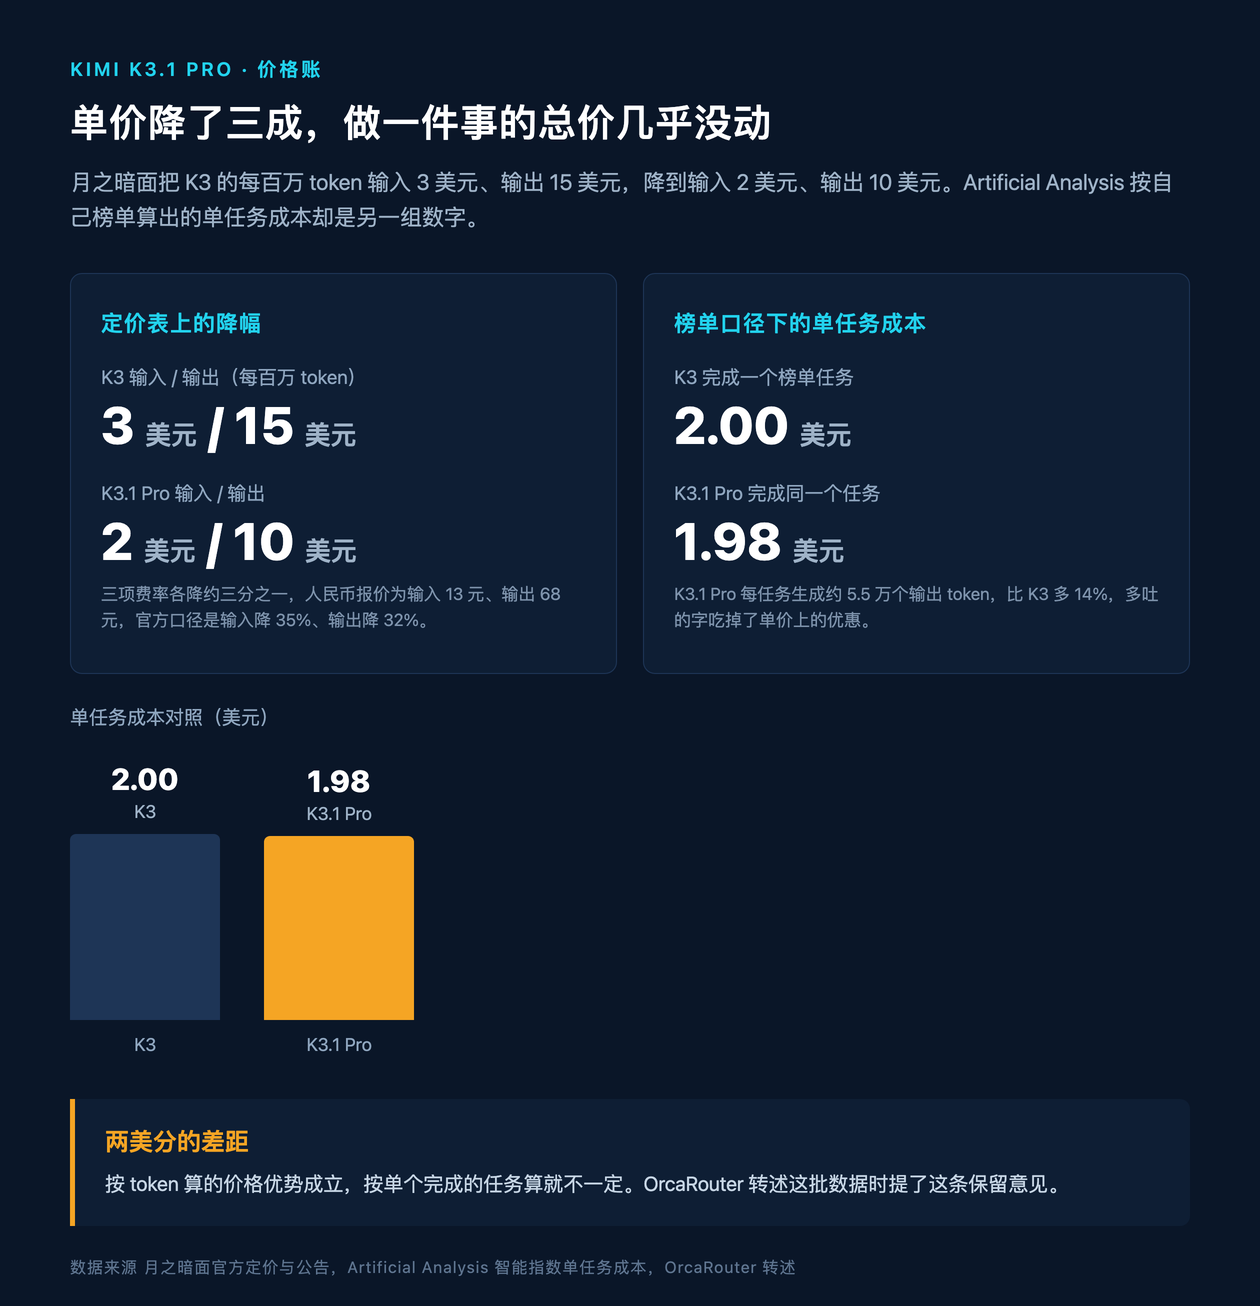
这个差别很实在。花钱买 API 的人最后付的是做完一件事的总价,每百万 token 的单价只是中间量。OrcaRouter 转述这批数据时提了两条保留意见,一条是 Terminal-Bench 的分数在不同推理设置下跑出来,另一条是 K3.1 Pro 相对 Opus 5.5 的价格优势按 token 算成立,按单个完成的任务算就不一定。我的看法是,这次降价对按量计费的散户意义有限。任务长、输出多的批处理场景更接近没降,多出来的那 14% 输出 token 正好吃掉了单价上的优惠。依据只有一条,就是 Artificial Analysis 公布的单任务成本,这个口径它自己没有展开,真实业务里的数字还得等有人跑上两周。
再说模型本身。K3.1 Pro 沿用了 7 月发布的 Kimi K3,架构和规模都没变,2.8 万亿总参数、约 1040 亿激活参数、100 万 token 上下文,这次做的是大规模后训练。月之暗面说它把强化学习铺到了数百个下游领域,同时重写了 RL 框架、长上下文推理、沙箱基础设施和 rollout 调度,让每一份新增的 RL 算力都能在多个方向上稳定兑现。官方演示里,它能直接写 Blender 与 FreeCAD 脚本,做出来的涡扇发动机模型可以在模拟环境里转起来,也能在虚幻引擎、Unity 这类游戏引擎里搭场景。另一次演示是它在一个开放的人体解剖模型上连做 167 个任务,中途自己诊断并改正了 36 处肩部肌肉计算的错误。
分数上最能说明问题的是 Terminal-Bench 4.0,65.7%,比 GPT-6 Astra 的 58.2% 高出一截,离 Claude Opus 5.5 的 66.4% 差不到一个点。GDPval-AA 上拿到 1846 Elo,Opus 5.5 是 1866。这两项出自 Artificial Analysis。剩下的分数多数由月之暗面自己报出。内部长程编码测试 Kimi Code Bench 3.0 从 55.95% 升到 61.2%,SWE-Marathon v1.1 以 51.7% 排第一,OfficeQA Pro v2 拿 64.4 分,带工具的 BenchCAD 是 92.7%,Opus 5.5 在同一项上是 96.2%。自报的分数看过就行,权重下来之后会有第三方复现,那才是能引用的数字。
月之暗面还报了一个我愿意看到的数字。声明级幻觉率在一个内部压力测试上从 23.4% 降到 8.3%,这个测试刻意做得很难,公司自己也写了它不反映日常使用中的错误率。另一件事更有信息量。月之暗面说它在通用训练数据里发现了网络安全相关内容,为这次开源版本把这类材料从中期训练和强化学习两个阶段里识别并删掉了,同时保留通用编码能力。开源权重一旦放出去就收不回来,发布方在放之前主动做一次能力裁剪,这类动作过去很少见,比多几个基准分数更有分量。
11 月 4 日这个日期值得单独说。榜单上的 55 分、官网与 App 的全量上线、API 的新价格,全都排在权重公开之前。接下来十天里,K3.1 Pro 是一个分数已被记进全球榜单、产品端已经能付费调用、第三方却拿不到权重做独立复现的模型。月之暗面去年 7 月把 K3 完整开源过一次,2.8 万亿参数全部放出,当时它是世上最大的开源权重模型,这次的信用基础就是那一次攒下的。我的判断是,把评分和权重错开十天,先把榜单位置与商业渠道占住再让社区去验,对发布方是一条很划算的顺序,只是这十天里「开源模型」这个称呼有一半属于承诺。
发布当晚 Hacker News 那条帖子涨到大约 850 分、近 500 条评论,讨论最集中的地方出人意料,是模型的说话方式。有人贴出它回复的原话,大意是这一点已经说过三遍,换个方式再问一遍也不会改变答案。高赞评论说它比美国那几家模型直得多,也爱争辩得多。这类反馈进不了任何榜单,但它决定的是一个人愿不愿意每天跟它打交道。
补一个背景数字。Hugging Face 2026 年的报告里,中国团队开发的开源模型占到平台下载量的 41%,美国是 35% 到 36.5%。K3.1 Pro 把开源与闭源的差距从 12 分压到 3 分,放在这个背景下顺理成章。压到 3 分之后,账单上省下来的钱只有两美分,这件事没多少人提。
支撑本文结论的来源有月之暗面官方发布与模型页、Artificial Analysis 智能指数与 GDPval-AA 榜单、CGTN 10 月 24 日报道 Kimi K3.1 Pro、The Decoder 同日报道、智东西 10 月 24 日实测报道、Hugging Face 2026 年开源模型报告。