Meta 新模型定价盯住 Opus,独立榜却低 6 分,最强版只随订阅卖
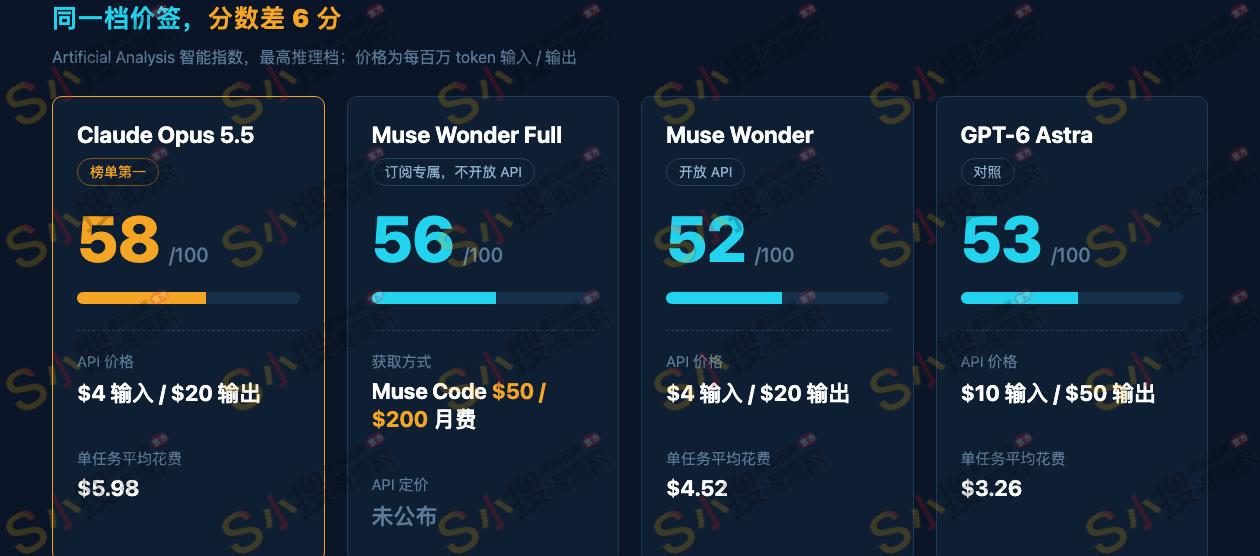
Meta 在 10 月 12 日发了两个模型。Muse Wonder 挂上 Meta Model API,模型名 muse-wonder-1.0,每百万输入 token 收 4 美元,输出收 20 美元,缓存输入 0.20 美元。这个价与 Anthropic 的 Claude Opus 5.5 一模一样,一个小数位都没差。
独立评测机构 Artificial Analysis 把它们放进了智能指数榜。最高推理档下 Muse Wonder 得 52 分,更强的 Muse Wonder Full 得 56 分。Claude Opus 5.5 是 58 分,OpenAI 的 GPT-6 Astra 与谷歌的 Gemini 4 Argon 都停在 53 分。Meta 官方说这两款对标前沿,榜单给出的位置是前沿旁边一格。
分数之外还藏着一笔账。Artificial Analysis 算过跑完一个评测任务的平均花费,Muse Wonder 是 4.52 美元,GPT-6 Astra 在对应档位只要 3.26 美元,Claude Opus 5.5 是 5.98 美元。单价相同,Meta 的单任务成本却比 Astra 高出近四成。原因写在测试口径里,它每个任务要吃掉 7.69M 输入 token。
规格上还有几项。两款模型都给到 104 万 token 的上下文窗口,能读文本、图像、音频、视频和 PDF,输出只有文字。这个窗口由输入和输出共用,长输入挤占的是回答的额度。联网搜索按每 1000 次查询 2.50 美元另收。
把价签放进整个市场看,Meta 的选择更清楚。GPT-6 Astra 卖每百万输入 10 美元、输出 50 美元,Claude Fable 5.1 更贵。Meta 自家的轻量模型 Muse Spark 1.3 只要输入 1.25 美元、输出 4.25 美元。Muse Wonder 落在中间偏上的位置,$4/$20 这一档正好与 Opus 5.5 的列表价重合,比 Astra 便宜一半上下。
Artificial Analysis 还给了细项。Muse Wonder Full 在它十项评测里有六项进前三,优势集中在智能体知识工作、业务流程和部分科学推理。在最高推理强度下,Muse Code 配 Wonder Full 的编程智能体成绩与 Claude Code 配 Sonnet 5.5 打平,略胜 Opus 5.5。这些名次的参考价值有限,它们衡量的是厂商把模型塞进自家工具后的效果。
Meta 卖这两款模型的方式也有讲究。Muse Wonder 公开挂上 API,OpenRouter 与 Muse Code 里都能调用。Muse Wonder Full 没有 API 价,只能通过 Muse Code 订阅拿到,月费 50 美元或 200 美元。200 美元那档叫 Maximum Usage,额度是 Everyday 档的 80 倍,重置节奏保持每五小时与每周各一次。
Meta 把最强的模型从 API 里摘出来,只放进自家订阅。这一手 OpenAI 与 Anthropic 都没做。两家的顶配模型都能按 token 买,价格高低是另一回事。Meta 反着走,因为 Muse 才是它要卖的生意。
Muse 是 Meta 九月上线的个人智能体,应用订阅分 20 美元与 100 美元两档。《华尔街日报》报道说,它的下载增长自上线以来在放缓。Muse Wonder 系列被官方定义成服务 Muse 的模型,重点押在两项能力。一项叫主动记忆,把用户此前说过的事跨对话带过去;另一项叫主动聚焦,让智能体在任务卡住时继续换方法试,并在动手改动前先向用户确认。
我的判断是,这次发布的关键不在基准分,在 Meta 交出的那张价签。它把 API 价与现行第一梯队定成一分不差,说明它已经不打算用价格换份额,Llama 时代把权重白送出去的做法到此结束。证据有两处,价格表完全相同,以及 Wonder Full 干脆不公开 API。
Muse Code 的订阅条款还有一处要留意。DataNorth 的报道说,Muse Code 默认会拿用户的代码内容训练模型,除非用户主动关掉 Contributor 模式。付了订阅费的人,默认设置是把内容交出去训练,这件事在发布稿里没有被强调。
官方那张比较表要单独读。表里 Wonder Full 在 SWE-Marathon 拿 57.5,Opus 5.5 是 46.3;Harvey LAB-AA 上 13.1 对 4.2;DeepSWE 1.1 上 79.0 对 74.2。这三项 Meta 领先。同一张表里,Terminal-Bench 4.0 是 57.1 对 59.6,HealthBench Pro 是 62.3 对 65.6,ProgramBench 是 59.0 对 70.5,这三项 Meta 落后。
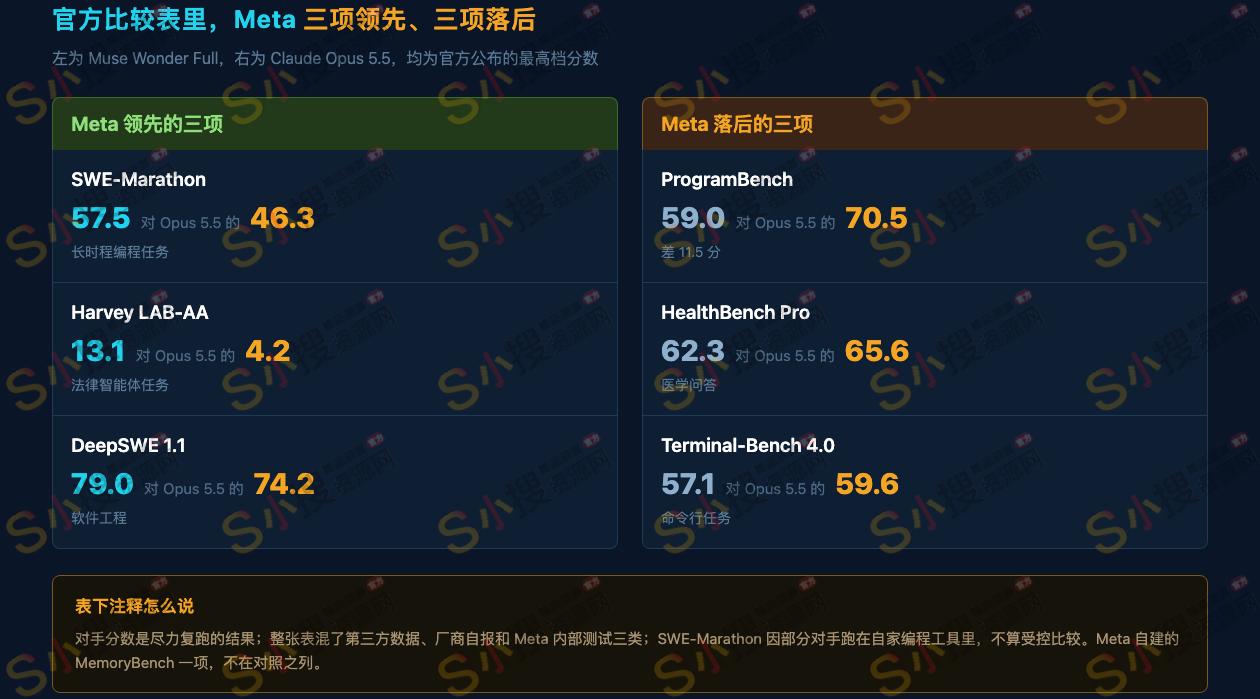
表下附了一段注释。它说对手分数是尽力复跑的结果,整张表混了第三方数据、厂商自报和 Meta 内部测试三类,SWE-Marathon 因为有的对手跑在自己的编程工具里,不算受控比较。领先那三项要打折看。我把 56 与 58 这 2 分的差距当成更可信的信号,它出自一家不靠 Meta 付钱的机构,排序也能和其他模型对上。
外部质疑也有。Abacus.AI 的 CEO Bindu Reddy 在 X 上写,Muse Wonder 离 Fable 与 Astra 的水平还差得远,说会补上详细跑分。这个质疑眼下只有表态没有数据,不过它和 Artificial Analysis 的 52 分指向同一个方向。
用户侧的反馈比榜单更早到。腾讯新闻 10 月 13 日的报道提到,网上已经有试用者说 Muse Wonder 在编程、3D 游戏制作这类任务上表现不佳。这类零散反馈不足以下定论,样本也小,方向却与独立榜的排序一致。
Meta 的模型从来都是闭的。Llama 4 在 2025 年反响平平之后,公司就没再朝开放权重那条路走。这次两款 Wonder 模型同样不公开权重,官方把商业模式押在 Muse 应用与 Muse Code 两处订阅上。
训练侧的信息更少。Meta 说这两款模型在俄亥俄中部的 Prometheus 数据中心训练,那是座千兆瓦级设施,具体用了多少算力始终没公布。安全报告官方承诺会发,到现在没出,权重也不公开,安全侧的结论因此还没有材料撑住。
Meta 走到这一步花了半年多重建。2025 年中,公司把超级智能实验室建起来,向数据标注公司 Scale AI 投了约 143 亿美元,并把它的创始人 Alexandr Wang 请来牵头。今年四月推出轻量的 Muse Spark,九月上线 Muse 个人智能体,十月这两款是实验室第一次把对标前沿说出口。Wang 在采访里的表态很直接,说这是前沿模型,持怀疑态度的人可以自己试用评判。
同一天市场给了正面反应,Meta 收涨约 3.38%,报 742.96 美元。股价和模型好不好用之间关系不大,这里只当个时间标记。公司二季度资本开支 310.8 亿美元,全年指引落在 1300 亿到 1450 亿美元之间,钱的规模摆在那里。
Muse Wonder 的 API 从 10 月 12 日起可用,Wonder Full 的订阅入口同一天开放,进 Muse 应用的时间官方只说订阅用户优先。这两款模型能不能把 Muse 的下载曲线拉回来,要看接下来几周的使用数据。Meta 至今没有公布 Muse 的留存或活跃口径,这件事外面的人还看不到答案。
来源
Meta 开发者博客,Put your ideas to work with Muse Wonder and Muse Wonder Full,2026 年 10 月 12 日
Artificial Analysis 智能指数榜与单任务成本估算,2026 年 10 月 13 日查询
Meta 官方比较表与 model card 注释,经 VentureBeat 报道
DataNorth AI,Meta 的 Muse Wonder 报道,2026 年 10 月 13 日
钛媒体,扎克伯格烤肉时预告的大西瓜落地,2026 年 10 月 12 日
《华尔街日报》关于 Muse 下载增长放缓的报道